Maintenance prédictive IA : la redondance ne suffit pas
Analyse de Eries Emmanuel Dianou · Maintenance, performance industrielle et transformation digitale
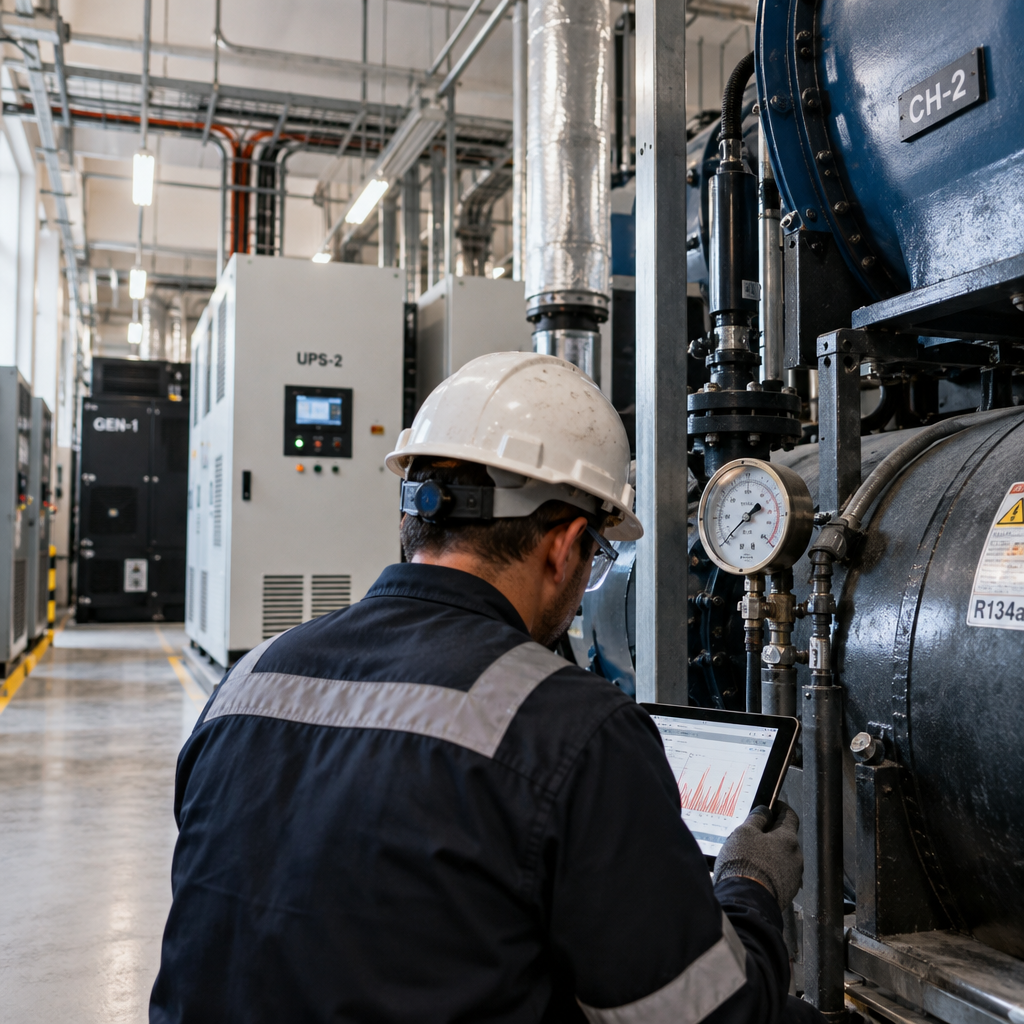
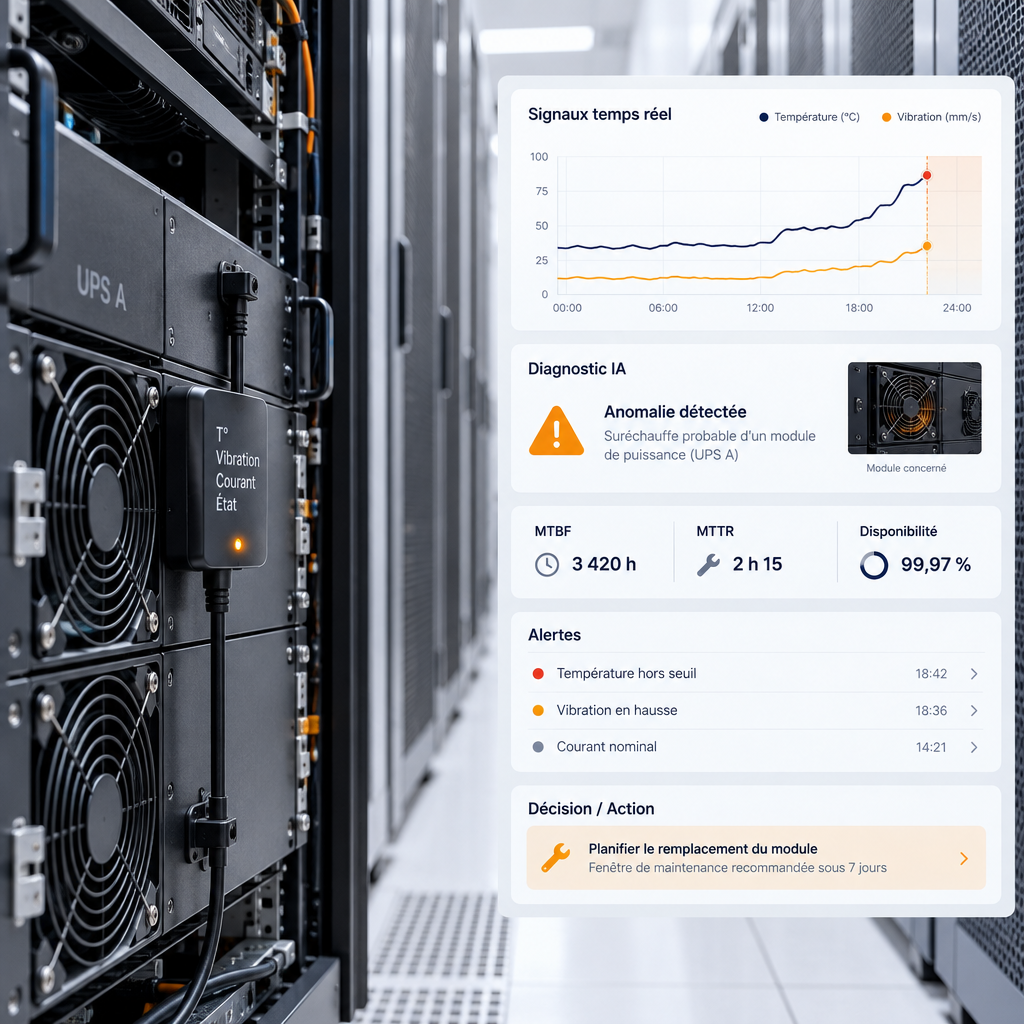
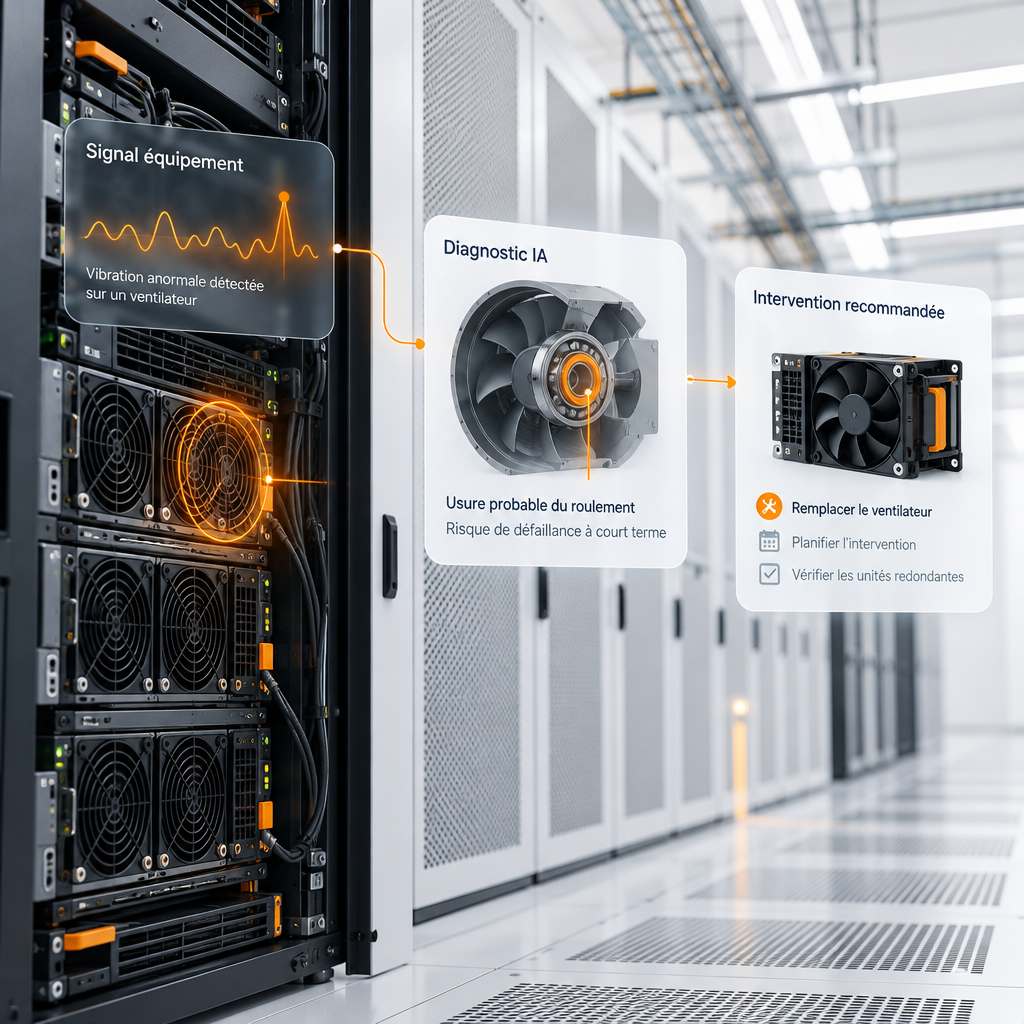
Ajouter de la redondance dans un data center peut donner une fausse impression de sécurité. Deux équipements disponibles à l'écran ne garantissent pas deux capacités réellement mobilisables lorsque la charge augmente ou que l'alimentation électrique bascule.
Le secours existe. Mais peut-il reprendre la charge dans les conditions du jour, avec une température extérieure élevée, un équipement déjà dégradé et une intervention en cours ? C'est cette différence entre disponibilité affichée et réserve réellement exploitable qui mérite d'être examinée avant d'investir dans l'intelligence artificielle, ou IA.
Pour un directeur des systèmes d'information (DSI) et un responsable de la sécurité des systèmes d'information (RSSI), la maintenance prédictive IA doit répondre à une question opérationnelle : comment anticiper une perte de redondance du refroidissement sans introduire un nouveau risque dans l'exploitation du data center ? Le point de départ n'est pas l'algorithme. C'est la capacité à maintenir le service pendant une dégradation.
La réserve de refroidissement doit se vérifier
Une architecture dite N+1 prévoit un élément supplémentaire par rapport au nombre nécessaire pour assurer la fonction attendue. Cette marge repose néanmoins sur des hypothèses de capacité, de charge et d'indépendance entre équipements qu'il faut vérifier dans les conditions réelles d'exploitation.
Le schéma ne suffit pas.
Un groupe de production d'eau glacée peut rester en fonctionnement tout en perdant progressivement de son efficacité, ce qui réduit la réserve disponible sans déclencher immédiatement une alarme de panne. Le danger apparaît lorsqu'un autre équipement devient indisponible : la capacité restante ne correspond plus à celle prévue dans le dossier de conception.
L'analyse doit donc suivre la chaîne de dépendances. Les UPS, systèmes d'alimentation sans interruption, et les groupes électrogènes participent à la continuité énergétique, mais leur présence ne prouve pas que tous les auxiliaires du refroidissement disposent d'une alimentation secourue et d'une séquence de reprise adaptée.
Dans certains data centers africains, la fréquence des basculements électriques ou les délais d'approvisionnement peuvent peser fortement sur les décisions. Ailleurs, la contrainte dominante sera différente : il faut partir des conditions du site, pas d'une représentation uniforme du continent.
La bonne référence est la capacité vérifiée. Elle tient compte des essais autorisés, des restrictions connues et de la charge informatique à soutenir pendant une indisponibilité.
Des données qui expliquent la dégradation
Avant de choisir un modèle, je propose de relier les mesures disponibles à une question précise : à conditions comparables, le refroidissement fournit-il toujours la même capacité utile ? Cette approche évite de confondre une variation normale de fonctionnement avec une dérive nécessitant une intervention.
La température seule ne tranche pas.
Une hausse peut suivre l'augmentation de la charge informatique, une modification de consigne ou une température extérieure plus élevée ; elle peut aussi révéler une dégradation qu'une lecture isolée ne permet pas d'identifier. Il faut rapprocher les températures d'entrée et de sortie, les débits disponibles, la puissance électrique absorbée et les états de fonctionnement.
Commencer par une référence explicable
Un seuil adapté aux conditions d'exploitation peut être plus utile qu'un modèle complexe entraîné sur un historique mal documenté. L'IA devient pertinente lorsqu'elle aide à reconnaître des écarts entre plusieurs variables que les équipes ne peuvent pas surveiller continuellement.
L'horodatage est déterminant.
Si les changements de consigne, les mesures thermiques et les événements électriques ne sont pas alignés, le modèle peut attribuer une conséquence à la mauvaise cause. Une connexion interrompue ne doit pas davantage transformer une dernière valeur connue en mesure prétendument actuelle.
Une supervision temps réel correctement structurée fournit ce socle, à condition d'afficher aussi la qualité et l'ancienneté des données. Ajouter des capteurs n'est justifié que lorsqu'une incertitude identifiée empêche réellement de décider.
Le RSSI doit cadrer le pilote dès le départ
Un projet prédictif ne doit pas ouvrir un chemin incontrôlé vers les installations techniques. Les systèmes de technologie opérationnelle, ou OT, qui pilotent le refroidissement et l'énergie ont des exigences de disponibilité qu'un simple raccordement à une plateforme analytique peut fragiliser.
La lecture seule est préférable au démarrage.
Elle ne suffit pourtant pas à garantir l'innocuité du dispositif : une collecte trop fréquente peut solliciter excessivement un contrôleur, et un compte de lecture mal protégé reste une porte d'entrée. Le pilote doit donc préciser les flux autorisés, leur fréquence, les droits d'accès et le comportement attendu lorsque la liaison disparaît.
Séparer observation et commande
Le moteur d'analyse peut recevoir des données depuis une zone intermédiaire sécurisée, sans disposer d'un accès direct aux commandes du refroidissement. Les recommandations passent ensuite par une validation humaine et par les procédures de changement du data center.
Aucune consigne ne doit changer automatiquement.
Cette séparation réduit le risque qu'une mauvaise inférence affecte la continuité de service, tout en permettant aux équipes de confronter les alertes aux conditions d'exploitation. Le RSSI doit aussi examiner la maintenance du logiciel, les accès du fournisseur, la journalisation et la possibilité de révoquer rapidement un compte.
L'hébergement mérite un arbitrage local. Selon le pays d'implantation, les contrats clients et la sensibilité des informations d'exploitation, une analyse sur site ou une architecture hybride peut être préférable ; les exigences de conservation et de transfert doivent être vérifiées, non supposées identiques partout.
Cas hypothétique : une réserve qui s'érode
Prenons un cas hypothétique : un data center utilise une production d'eau glacée organisée en N+1. Les écrans ne signalent aucune panne, mais l'un des groupes absorbe progressivement davantage d'énergie pour un refroidissement comparable, après prise en compte de la charge et des conditions extérieures.
L'exploitation continue normalement.
L'analyse détecte une dérive persistante, sans pouvoir conclure à elle seule s'il s'agit d'un échange thermique dégradé, d'une mesure incorrecte ou d'un autre défaut. Le technicien vérifie d'abord la cohérence des sondes et les paramètres accessibles selon les procédures du site ; une inspection ciblée peut ensuite être autorisée.
L'enjeu dépasse la consommation électrique. Si ce groupe fournit moins de capacité utile que prévu, l'arrêt planifié d'un autre groupe peut supprimer la réserve attendue au moment où le data center en a besoin.
L'alerte doit rendre cette conséquence lisible.
Plutôt qu'un simple score de risque, le DSI reçoit une recommandation contextualisée : vérifier la capacité restante avant d'autoriser l'arrêt programmé, avec les observations qui justifient cette prudence et les incertitudes encore présentes. Le technicien conserve la responsabilité de confirmer les éléments physiques.
Un délai de pièce allongé change alors l'arbitrage. Selon les résultats du contrôle, l'équipe peut avancer un approvisionnement, reporter l'intervention prévue ou adapter temporairement la charge, sans que l'IA décide seule d'une action affectant le service.
La GMAO conserve son rôle, mais pas toute la réponse
La gestion de maintenance assistée par ordinateur, ou GMAO, organise les interventions, les échéances, les pièces et l'historique des équipements. Elle reste indispensable pour savoir ce qui a été demandé, exécuté et constaté.
Elle ne suffit pas toujours pour anticiper.
Enregistrer un entretien ne permet pas, à lui seul, d'établir si une dérive thermique compromet la réserve disponible pendant le prochain arrêt technique. Certaines GMAO disposent de fonctions analytiques avancées ; la distinction utile porte donc sur les capacités effectives, pas seulement sur le nom du logiciel.
L'approche LMAI® ajoute une couche d'assistance au diagnostic, à l'anticipation et à la décision, en rapprochant les observations techniques et le contexte de maintenance. Le comparatif GMAO vs LMAI® aide à comprendre cette complémentarité.
Je porte TENGENN LMAI® dans cette logique. Pour ce besoin précis, je propose de cadrer son utilisation autour de recommandations traçables, reliées aux données disponibles et soumises à la validation de l'exploitation, plutôt que de promettre une prédiction universelle.
Le résultat attendu doit rester vérifiable. Une recommandation utile explique ce qui dérive, pourquoi cela peut affecter la redondance, quelle vérification effectuer et dans quelles limites l'analyse reste valable.
Un pilote doit prouver son utilité opérationnelle
Mes sept années d'expérience dans différents environnements industriels m'ont conduit à privilégier une règle simple : une information technique vaut surtout par la décision qu'elle permet de prendre. Pour un data center, je préfère une alerte explicable sur la réserve de refroidissement à une multitude de notifications sans suite claire.
Le périmètre initial doit rester étroit.
Je propose d'abord un diagnostic de la réserve réellement disponible, en rapprochant architecture, mesures, historique et règles d'exploitation ; il sert à déterminer ce que les données peuvent démontrer et ce qu'un contrôle physique doit encore confirmer.
Je peux ensuite accompagner un pilote sur une chaîne de refroidissement identifiée, avec l'exploitation et le RSSI. La méthode prévoit un fonctionnement d'observation, sans commande automatique, puis une revue des alertes avant leur utilisation dans les décisions de maintenance.
Enfin, j'aide à formaliser la réponse attendue. Chaque signal doit avoir un destinataire, une vérification associée et une règle d'escalade compatible avec les procédures du site.
Mesurer autre chose que le nombre d'alertes
Le pilote doit examiner la proportion de notifications exploitables, le délai disponible pour vérifier la dérive et la charge de travail créée. Les périodes sans données, les changements de configuration et les alertes non confirmées doivent figurer dans le bilan.
Une panne évitée ne se décrète pas.
Sans événement documenté et sans méthode d'évaluation solide, attribuer un gain financier à l'IA serait fragile ; l'amélioration démontrable peut d'abord être une meilleure justification des autorisations d'intervention. C'est déjà une base utile pour décider d'élargir, de corriger ou d'arrêter le pilote.
Questions fréquentes
Faut-il disposer d'un historique de pannes ?
Pas nécessairement pour repérer des anomalies par rapport à un fonctionnement de référence. En revanche, annoncer précisément un mode de défaillance ou une durée avant panne exige des données pertinentes et une validation nettement plus exigeante.
Peut-on travailler avec une connectivité extérieure instable ?
Oui, si l'architecture prévoit une collecte locale, une conservation adaptée et une reprise maîtrisée des échanges. Le refroidissement doit continuer à fonctionner indépendamment de la plateforme analytique, et toute interruption doit être visible dans la qualité des résultats.
L'IA remplace-t-elle les essais de secours ?
Non. Elle peut aider à préparer les contrôles et à repérer certaines dérives, mais elle ne démontre pas à elle seule le comportement réel des UPS, des groupes électrogènes ou du refroidissement pendant une séquence de basculement.
Partir de votre prochaine intervention critique
La maintenance prédictive IA devient utile lorsqu'elle éclaire une décision concrète : peut-on retirer cet équipement du service sans perdre la marge nécessaire ? Elle ne remplace ni les essais, ni les procédures, ni le jugement des équipes ; elle leur apporte des éléments mieux reliés au risque de continuité.
Votre prochain arrêt technique est un bon point de départ.
Contactez-moi directement sur mon profil LinkedIn, Eries Emmanuel Dianou : je vous propose un échange sur votre chaîne de refroidissement, les données disponibles et les vérifications nécessaires pour savoir si votre redondance affichée correspond bien à une réserve exploitable.
Poursuivre l’échange
Une question sur votre organisation maintenance ou votre transformation industrielle ? Échangez avec Eries Emmanuel Dianou.
Visiter TENGENN