Maintenance prédictive IA : protéger votre data center
Analyse de Eries Emmanuel Dianou · Maintenance, performance industrielle et transformation digitale
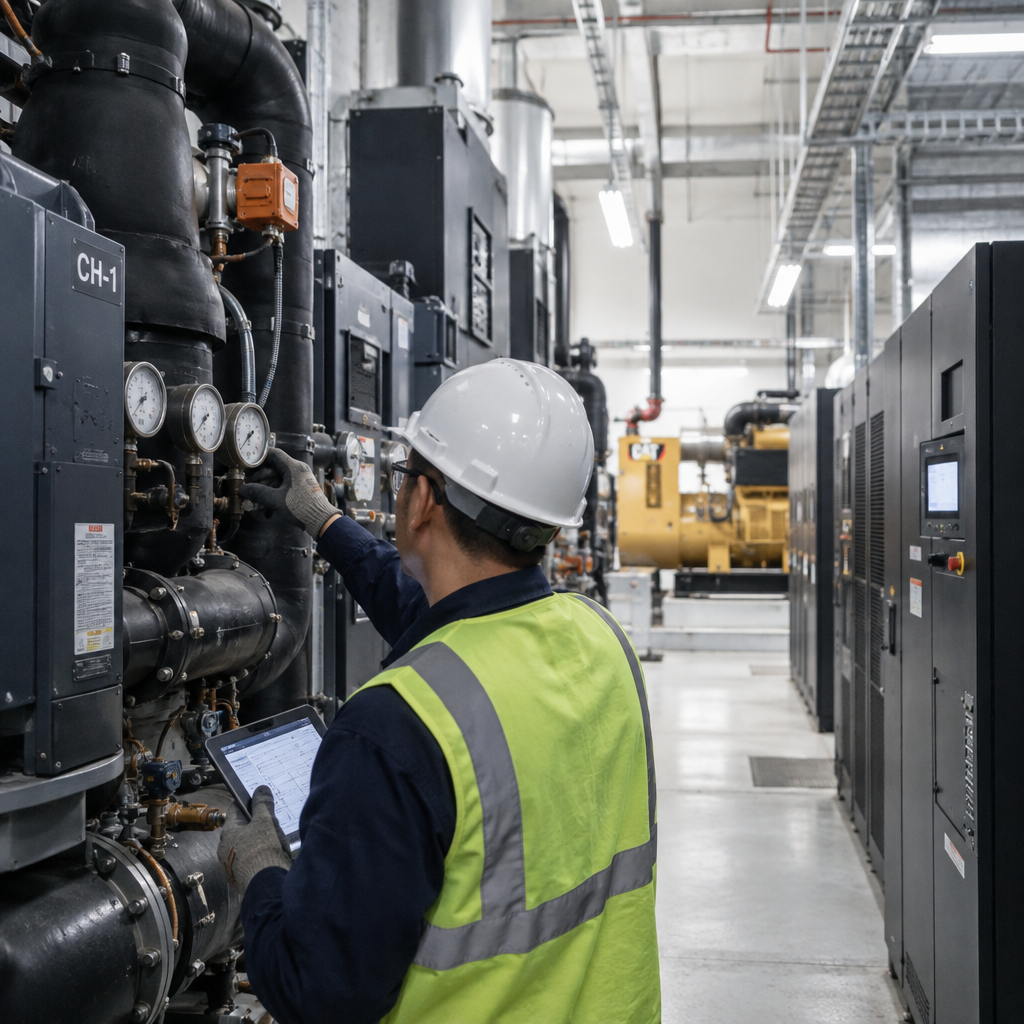
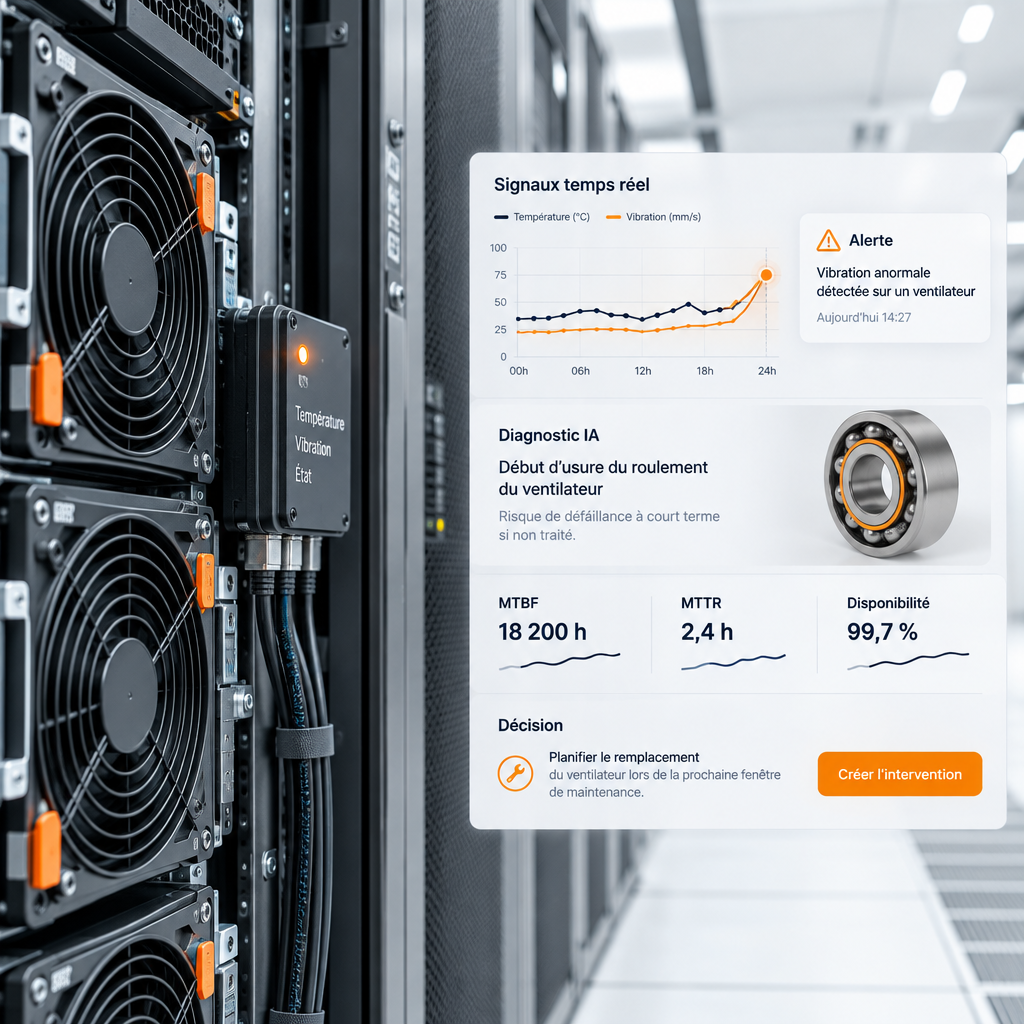
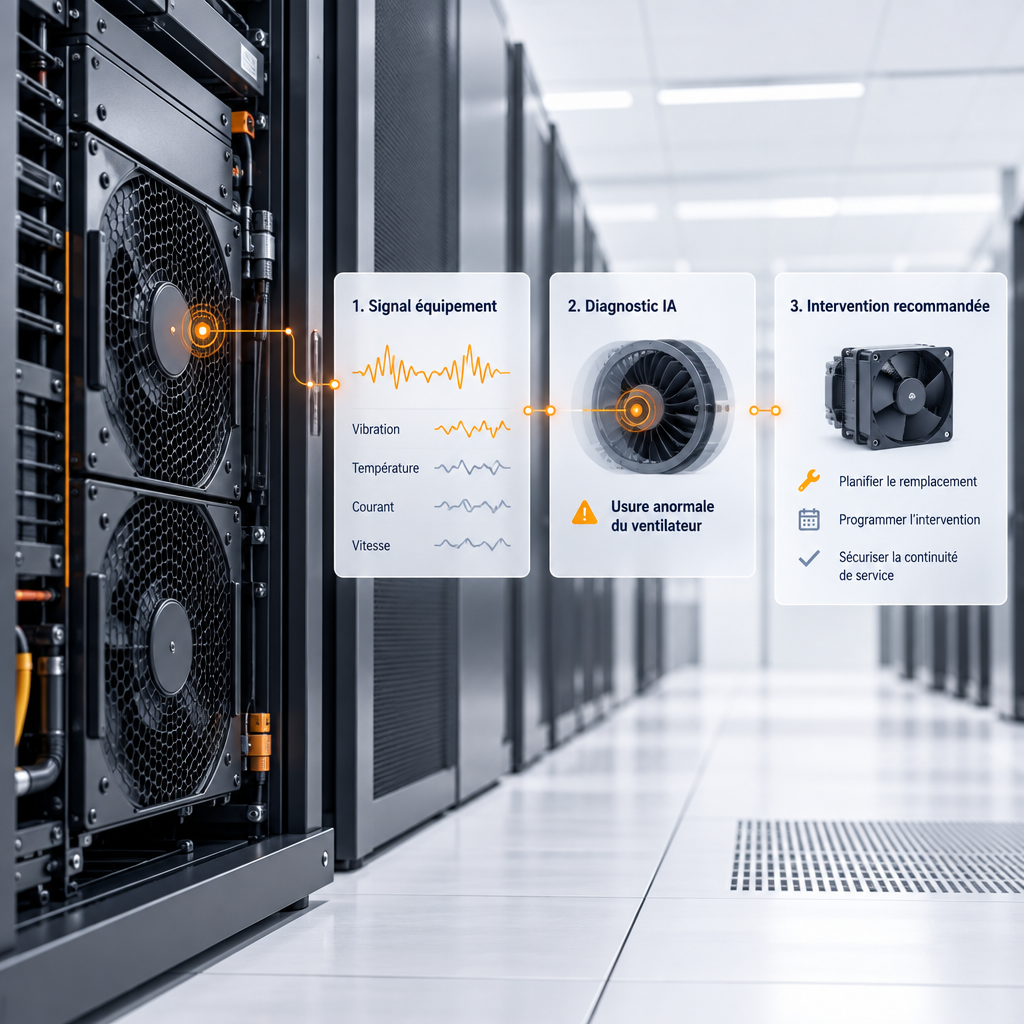
Comment savoir si votre refroidissement tiendra réellement la charge lorsqu'une unité sera indisponible, alors que tous les voyants du data center sont encore au vert ?
La question revient derrière beaucoup de décisions de maintenance : peut-on isoler cet équipement maintenant, ou risque-t-on de découvrir trop tard que la redondance n'existe plus que sur le schéma ? Une température conforme à l'instant présent ne donne pas cette réponse.
C'est là que la maintenance prédictive IA, fondée sur l'intelligence artificielle, peut devenir utile. Pour les directeurs des systèmes d'information, les DSI, et les responsables de la sécurité des systèmes d'information, les RSSI, l'enjeu consiste à détecter une perte progressive de capacité de refroidissement avant qu'elle ne compromette la continuité de service, sans ouvrir une nouvelle porte dans le système d'information.
Le risque caché derrière un refroidissement normal
Un data center peut maintenir ses températures cibles avec une installation qui se dégrade. La régulation compense : les ventilateurs accélèrent, les équipements fonctionnent plus longtemps et la consommation augmente pour une charge informatique comparable.
La marge disparaît sans alarme franche.
Une configuration N+1 prévoit une unité supplémentaire par rapport au nombre nécessaire pour assurer le besoin nominal. Elle ne garantit pourtant pas que les unités restantes fourniront leur capacité attendue au moment d'une maintenance, surtout si leur performance réelle a diminué ou si elles partagent une dépendance vulnérable.
La question pertinente devient donc : quelle capacité reste disponible après le retrait d'une unité, dans les conditions réelles du site ? Elle relie directement le travail du technicien à l'arbitrage du directeur qui autorise une intervention.
Dans certains data centers africains, cette décision doit aussi intégrer des délais d'approvisionnement longs ou des conditions électriques variables. Ailleurs, ces facteurs seront secondaires ; il faut documenter le site, son climat, ses contrats de support et son architecture plutôt que lui appliquer un scénario régional uniforme.
L'énergie compte également. Lors d'un transfert sur groupes électrogènes, il faut connaître le comportement du refroidissement, ses séquences de redémarrage et la capacité réellement disponible pendant la transition. Les UPS, ou alimentations sans interruption, protègent les charges prévues par l'architecture électrique ; leur présence ne prouve pas que toute la chaîne de refroidissement bénéficie de la même continuité.
Avant le modèle, reconstituer la marge thermique
Je commencerais par un périmètre restreint : une salle et les équipements qui assurent son refroidissement. Chercher à couvrir immédiatement tout le data center rend souvent les données plus nombreuses que les décisions exploitables.
Il faut d'abord reconstruire les dépendances.
Le schéma doit relier les unités de refroidissement à leurs alimentations, aux circuits communs et aux zones desservies, puis préciser ce qui subsiste lorsqu'un équipement est isolé. Une redondance apparente peut dépendre d'un même organe auxiliaire ; aucun algorithme ne corrigera cette fragilité d'architecture.
Des mesures comparables, pas seulement disponibles
Pour apprécier une dérive, je rapprocherais la puissance informatique, les températures à l'entrée des baies, les conditions extérieures et les états de fonctionnement du refroidissement. Selon la technologie installée, les débits, les pressions ou les vitesses de rotation peuvent compléter cette lecture.
Chaque mesure doit avoir un sens.
Une sonde déplacée ou un horodatage décalé peut créer une anomalie artificielle, tandis qu'une température moyenne de salle peut masquer une zone chaude. Avant de demander au modèle de reconnaître une dégradation, l'équipe doit donc vérifier les unités, la localisation des capteurs et la cohérence temporelle des historiques.
Les comptes rendus de maintenance industrielle donnent ensuite le contexte : nettoyage, remplacement, modification de consigne ou indisponibilité planifiée. Sans ces événements, une évolution normale après intervention risque d'être interprétée comme une nouvelle panne.
Définir la décision attendue
Le premier livrable ne devrait pas être un tableau de bord supplémentaire. Il devrait préciser qui vérifie une alerte, quelles observations sont nécessaires et qui peut autoriser le retrait d'une unité.
L'objectif est concret : étayer une décision de maintenance sans surestimer la réserve thermique. Une alerte qui ne change aucune action documentée n'a pas encore démontré son utilité.
Maintenance prédictive IA : prévoir sans surpromettre
Un seuil fixe indique qu'une température a dépassé une limite. Un modèle peut rechercher autre chose : un comportement devenu inhabituel pour une charge informatique, une température extérieure et un état d'exploitation donnés.
La différence est décisive.
Si une unité demande progressivement davantage d'énergie pour un service comparable, cette évolution peut justifier une investigation avant le déclenchement d'une alarme classique. Elle ne suffit cependant pas à identifier automatiquement une cause : encrassement, mesure défectueuse et modification des flux d'air peuvent produire des signatures proches.
Commencer par une référence compréhensible
Je privilégierais d'abord une référence simple, fondée sur les régimes de fonctionnement connus. Le modèle doit comparer des situations comparables et rendre visible l'écart observé, plutôt que produire un score opaque présenté comme une certitude.
La prédiction exige davantage de preuves.
Détecter une dérive relève déjà d'une surveillance conditionnelle utile ; annoncer un horizon de défaillance suppose des historiques adaptés, des événements documentés et une validation spécifique. Si ces éléments manquent, mieux vaut parler d'anticipation d'une perte de performance que promettre une date de panne.
Les sorties attendues restent sobres : l'équipement concerné, les variables qui motivent le signal, les conditions de validité et la vérification recommandée. La capacité résiduelle doit, elle, s'appuyer sur des données techniques et des essais maîtrisés, pas sur le seul score d'un modèle.
Tester avant de rendre l'alerte opérationnelle
Une période d'observation sans commande automatique permet de confronter les alertes aux constats des équipes. Il faut examiner les fausses alertes, les dérives manquées et le délai réellement disponible pour agir.
Un régime inédit doit être signalé.
Après une extension informatique ou une modification importante du refroidissement, la référence peut ne plus être valable. La supervision temps réel conserve alors ses alarmes de sécurité indépendantes : le modèle apporte une lecture supplémentaire, il ne remplace ni les protections ni les procédures d'exploitation.
DSI et RSSI : sécuriser la chaîne de décision
Le raccordement des données de refroidissement concerne les systèmes OT, c'est-à-dire les technologies qui surveillent ou pilotent les équipements physiques. Leur disponibilité reste prioritaire, même lorsqu'un projet analytique paraît limité à la lecture de mesures.
L'accès mérite donc une revue complète.
Pour ce périmètre, je proposerais une collecte en lecture seule lorsque l'architecture le permet, des flux explicitement autorisés entre zones et des comptes techniques aux droits minimaux. Le traitement analytique ne doit pas devenir un passage obligé pour le fonctionnement des automatismes.
Les accès de support nécessitent aussi une durée limitée, une authentification adaptée et une traçabilité exploitable. Un accès distant permanent accordé par commodité peut annuler une partie des précautions prises ailleurs.
Préserver le service lorsque l'analyse s'arrête
Une perte de connexion ne doit pas désorganiser le refroidissement. Selon les contraintes du data center, une collecte locale avec stockage tampon peut maintenir les historiques jusqu'au retour du lien, sans imposer un fonctionnement exclusivement connecté.
Les données anciennes doivent être visibles comme telles.
Une recommandation fondée sur des mesures périmées ne doit jamais apparaître comme une évaluation actuelle de la marge thermique. Le RSSI examinera également la protection des historiques, des paramètres et des versions du modèle, car leur altération peut influencer une décision de maintenance sans toucher directement une commande.
Les obligations d'hébergement, de conservation et de notification dépendent du pays, des contrats et du statut de l'opérateur. Elles doivent être vérifiées pour le data center concerné, sans supposer qu'un même cadre réglementaire s'applique partout.
Cas hypothétique : faut-il isoler cette unité ?
Prenons un cas entièrement hypothétique : un data center dispose d'une salle refroidie selon une architecture N+1 et prévoit l'entretien d'une unité. Les températures restent conformes, mais une autre unité absorbe progressivement davantage d'énergie dans des conditions de charge et d'ambiance comparables.
Le signal ne prouve aucune panne.
La première vérification porte sur les mesures et les changements récents d'exploitation ; le technicien contrôle ensuite les points suggérés par les données, dans le respect des procédures du site. L'analyse cherche surtout à déterminer si cette unité peut encore fournir la capacité attendue pendant l'arrêt de sa voisine.
Le transfert sur groupes électrogènes entre également dans l'examen si ce régime est pertinent pour la fenêtre prévue. Il ne s'agit pas de provoquer un essai risqué : l'équipe consulte les essais documentés, les séquences validées et les limites connues de continuité du refroidissement.
La décision reste humaine.
Selon les éléments recueillis, l'exploitation peut maintenir l'intervention avec des conditions renforcées, la reporter ou traiter d'abord l'unité suspecte. Aucun gain chiffré n'est supposé ici ; la valeur recherchée consiste à éviter une autorisation fondée uniquement sur des voyants verts et une redondance théorique.
De la GMAO à une aide à la décision exploitable
La GMAO, gestion de maintenance assistée par ordinateur, organise les interventions, conserve les comptes rendus et suit les équipements. Elle reste essentielle pour savoir ce qui a été fait et préparer ce qui doit l'être.
Seule, elle ne répond pas à tout.
À moins de fonctions analytiques spécifiques intégrées, elle ne rapproche pas automatiquement la charge informatique, les conditions thermiques, les dépendances électriques et les dérives de performance pour éclairer une indisponibilité planifiée. Le LMAI®, système logiciel de maintenance intégrant l'IA, vise à compléter ce socle : aider à diagnostiquer, anticiper et décider, plutôt que seulement enregistrer.
Avec TENGENN LMAI®, la solution que je porte, je propose d'étudier cette articulation entre historiques de maintenance et données d'exploitation. Les possibilités doivent être validées selon les interfaces disponibles et la qualité des données ; un logiciel ne reconstitue pas une mesure absente et ne certifie pas une redondance.
La distinction GMAO vs LMAI® prend ici un sens pratique : conserver la traçabilité, puis ajouter une analyse argumentée que l'équipe peut vérifier.
Mes sept années d'expérience dans différents environnements industriels nourrissent une conviction : une recommandation vaut par les vérifications qu'elle permet. Pour votre data center, je peux proposer un diagnostic ciblé de la marge de refroidissement, accompagner la sécurisation du circuit de données avec la DSI et le RSSI, puis cadrer un pilote d'aide à la décision avec l'exploitation.
Questions fréquentes
Faut-il beaucoup d'incidents pour commencer ?
Non, pas pour établir une référence de fonctionnement et repérer des écarts. En revanche, prédire précisément une défaillance demande des données pertinentes et une validation que quelques anomalies ne suffisent pas à fournir.
L'IA peut-elle autoriser seule une intervention ?
Ce n'est pas l'approche que je recommande. L'autorisation doit rester inscrite dans la procédure de changement du data center, avec vérification de la capacité résiduelle et validation des responsables désignés.
Quel périmètre choisir pour un premier pilote ?
Une salle, sa chaîne de refroidissement et une décision récurrente, comme le retrait planifié d'une unité. Ce cadre permet de juger l'utilité des alertes sans disperser les équipes.
La maintenance prédictive IA devient pertinente lorsqu'elle rend une décision de continuité de service mieux étayée, pas lorsqu'elle ajoute simplement un écran. Vous devez prochainement isoler une unité sans disposer d'une vision fiable de votre réserve thermique ? Contactez-moi directement via mon profil LinkedIn, Eries Emmanuel Dianou, pour examiner les données disponibles et définir un diagnostic adapté à votre data center.
Poursuivre l’échange
Une question sur votre organisation maintenance ou votre transformation industrielle ? Échangez avec Eries Emmanuel Dianou.
Visiter TENGENN